RCC-Environments und die Supply Chain
Ein Workflow, mit dem Du die Gefahr von Supply-Chain-Attacken deutlich reduzieren kannst.
Robotmk nimmt Dir eine Menge Arbeit ab:
Du hinterlegst in einer Konfigurationsdatei (conda.yaml), welche Pakete Dein Test braucht, und der überwachte Host baut sich die passende Laufzeitumgebung für Robot Framework selbst zusammen.
Das ist bequem. Es heißt aber auch: Dieser Host lädt Code aus dem Internet und führt ihn aus - unbeaufsichtigt, und mit Zugangsdaten für die Anwendungen, die er testet.
Im Rahmen eines Kundenprojektes habe ich mir einmal genauer angesehen, was beim Bau eines solchen Environments tatsächlich passiert: welche Pakete woher kommen, wo die Lieferkette hält und wo nicht.
Herausgekommen ist keine Sicherheitslücke - sondern eine Erkenntnis, die mich am Ende selbst überrascht hat: Der wirksamste Hebel ist eine einzige Datei. Du musst sie nur clever nutzen.
Ein kurzes Vorwort zu RCC
RCC wurde ursprünglich von Robocorp entwickelt.
Robocorp war ein Startup, das Robot Framework in die Cloud bringen wollte.
RCC sollte für die Automatisierungen einen stabilen und idempotenten Unterbau garantieren - auf Kundenseite (während der Entwicklung) und in der Cloud (bei der Ausführung).
Nach der Übernahme durch Sema4.ai im Jahr 2024 wurde das Werkzeug neu lizenziert und ist heute proprietär; die Weiterentwicklung der offenen Version wurde eingestellt.
Checkmk pflegt seitdem einen eigenen Fork auf Basis der letzten quelloffenen Fassung, der fester Bestandteil von Robotmk/Synthetic Monitoring ist.
(RCC kann auch ohne Robotmk genutzt werden, z.B. für die lokale Entwicklung von Robot Framework Automatisierungen. In diesem Artikel geht es aber um die Nutzung in Verbindung mit Robotmk.)
RCC kann unter diesem Link heruntergeladen werden: Robotmk Releases
Das Problem kompakt erklärt
Die Pakete, die RCC für Robot Framework installiert, kommen von öffentlichen Plattformen wie PyPI und npm - dort darf grundsätzlich jeder etwas veröffentlichen.
Und genau da liegt das Problem: Wenn ein Maintainer eines Pakets plötzlich eine manipulierte Version nachschiebt, holt sich Dein Robotmk-Host diese Version beim nächsten Bau von ganz allein.
Der Fachbegriff hierfür ist “Supply-Chain-Angriff”: der Angreifer greift Dich nicht direkt an, sondern über etwas, das Du benutzt und dem Du vertraust.
Die bekannten Fälle der letzten Jahre liefen fast alle so ab.
Konkretes Beispiel
Hier eine conda.yaml, mit der RCC ein typisches Environment mit Robot Frameowrk, BrowserLibrary und CryptoLibrary baut:
channels:
  - conda-forge
dependencies:
  - python=3.12
  - pip=23.2.1
  - nodejs=22.11.0
  - pip:
      - robotframework==7.4
      - robotframework-browser==19.14.2
      - robotframework-crypto==0.3
rccPostInstall:
  - rfbrowser init chromium
Ich erkläre zunächst die Inhalte von oben:
- Python, Pip und NodeJS werden von https://conda-forge.org geladen, einem Community-getriebenen Repository.
- Pip (Pythons interner Paketmanager) installiert die drei Pakete unterhalb des
pip:-Schlüssels - Im Falle der Browser Library kommt noch die letzte Zeile hinzu:
rfbrowser initstartet ein Python-Programm, mit dem das auf NodeJS basierende Playwright initialisiert wird. Darauf gehen wir jetzt genauer ein.
Dependencies unter der Lupe
NodeJS
Der ganz unten stehende PostInstall-Befehl rfbrowser init installiert u.a. Playwright, und das kommt mit einer Datei namens package-lock.json, in der jedes Paket mit exakter Version und Prüfsumme steht.
Da sämtliche Pakete mit exakter Version und Prüfsumme installiert werden, kann nichts unbemerkt hineinrutschen.
Browser-Binaries
In rfbrowser init werden auch die Browser-Binaries (hier nur “Chromium”) von einem CDN heruntergeladen.
Eine Prüfsumme wird dabei nirgends verglichen.
Python
Die conda.yaml gibt zwar nur drei Python-Pakete mit fester Version an…
  - pip:
      - robotframework==7.4
      - robotframework-browser==19.14.2
      - robotframework-crypto==0.3
…aber im fertigen Environment liegen deutlich mehr.
Wie kann das sein?
Ganz einfach: zwei der drei Python-Pakete nutzen im Hintergrund andere Python-Pakete. Wie diese Abhängigkeiten heißen und welche Versionen installiert werden, ist in den Paketen selbst definiert - wie genau (z.B. mypackage>=2.1 oder mypackage), siehst Du aber nicht.
Das bedeutet, dass es keine Garantie dafür gibt, dass sich ein Environment immer wieder mit dem gleichen Endergebnis bauen lässt.
Morgen schon könnte ein Maintainer eine neue Version seines Pakets veröffentlichen, die wiederum andere Pakete nachzieht - und eines dieser Pakete könnte kompromittiert sein.
Das ist kein Fehler von Robotmk oder RCC, sondern ein generelles Problem der Lieferkette:
man vertraut den Paketen, die man installiert, und somit auch den Paketen, die diese Pakete nachziehen.
Das Problem: frisch kompromittierte Pakete
Ein frisch kompromittiertes und veröffentlichtes Paket steht für ein bestimmtes Zeitfenster X erst mal in keiner Malware-Datenbank.
In diesem Zeitfenster kann also theoretisch Schadcode unbemerkt in Dein Environment gelangen.
Gegen diese Art von Angriffen braucht man einen kontrollierten Bauprozess, der Dir die Kontrolle über die folgenden Aspekte gibt:
- Zeit. Environments nicht auf brandneuen Versionen bauen. Kompromittierte Pakete werden meist binnen weniger Tage entdeckt und von den Repos entfernt.
- das Artefakt: Ein einmal gebautes, gescanntes und “eingefrorenes"Environment kann sich kein neues bösartiges Paket einfangen.
Das Rezept zu mehr Sicherheit in sechs Schritten
Im Standardbetrieb baut jeder Robotmk-Host sein Environment selbst.
Das heißt: Jeder dieser Hosts lädt sich selbst die Quellen von PyPI, der npm-Registry und CDNs.
Bei fünf Robotmk-Hosts ergibt das also fünf unbeaufsichtigte Einkaufstouren.
Wie man fertig gebaute Environments aus einem ZIP-File laden kann, habe ich in RCC-Environments in isolierten Umgebungen schon einmal beschrieben - dort mit dem Fokus auf einer reinen Lösung für air-gapped Hosts ohne jegliche Internetverbindung.
Diesen Mechanismus machen wir uns hier in einem kompletten Workflow zunutze, mit dem Du das Risiko von Supply-Chain-Attacken deutlich reduzieren kannst.
Um es bildlich zu sagen: die ZIP-Datei, in die sich ein RCC-Environment exportieren lässt, enthält nicht einfach nur den “Einkaufszettel”, sondern packt den komplett beladenen Einkaufswagen (die Browser-Binaries eingeschlossen) zusammen.
Wenn der Robotmk-Scheduler später das Environment aus dem ZIP-File rekreiert, gibt es keine Möglichkeit, dass sich noch Schadcode einschleust.
Big Picture
Bevor wir in die einzelnen Schritte einsteigen, möchte ich die vier Artefakte hervorheben, die darin entstehen.
Jedes Artefakt hat eine spezifische Rolle und beantwortet eine andere Frage:
| Schicht | Artefakt | Beantwortete Frage |
|---|---|---|
| I. die Absicht | conda.yaml | Was will ich im Environment nutzen? |
| II. der Bauplan | environment_<os>_<arch>_freeze.yaml | Was soll genau installiert werden? |
| III. die Bewertung | requirements.txt, package-lock.json | Sind die Python/Node-Pakete in Ordnung? |
| IV. das Endprodukt | hololib.zip | Das komplette, eingefrorene Environment |
Schritt 1 - Leg ein Referenzsystem an
Referenzsystem = Ein Host je Plattform, mit Internetzugang, so nah wie möglich an der Zielumgebung: gleiche OS-Version, gleiche Architektur. Der einzige Ort, an dem jemals ein Paket aus dem Internet gezogen wird.
Auf dem Referenzhost brauchst Du:
- Ein Robot-Framework-Verzeichnis mit
robot.yamlundconda.yaml - RCC (Download)
- Das Script
depguard.py(Download von Gist) - (optional) OSV-Scanner von Google (Download von OSV Releases, wird von
depguard.pyautomatisch heruntergeladen, falls nicht vorhanden)
Schritt 2 - Environment bauen
Wechsle in das Robot-Verzeichnis und baue das Environment:
rcc task script --space refbuild --robot robot.yaml -- python --version
Dieser Befehl baut ein komplettes Robot-Framework-Environment, inklusive Browser-Binaries:
rcc task script: Startet den Befehl hinter dem doppelten Bindestrich--space refbuild(optional, empfohlen): Weist RCC an, nicht das Environment im Default-Namespace zu überschreiben.--robot robot.yaml: Gibt den Pfad zur RCC-Configdatei an (die aufconda.yamlverweist)--: Trennt die RCC-Parameter von dem Befehl, der im Environment ausgeführt werden sollpython --version: Ein beliebiger Befehl, der im gebauten Environment ausgeführt wird. Ich habe hierpython --versiongewählt, weil er schnell ist und keine weiteren Abhängigkeiten hat.
Gleichzeitig legt RCC eine “Freeze"-Datei an: sie befindet sich im Unterordner output. Darin hat RCC nun alle transitiven Abhängigkeiten (Python & Node) mit ihrer exakten Version festgeschrieben.
RCC benennt die Freeze-Datei nach dem Schema environment_<os>_<arch>_freeze.yaml, wobei die Platzhalter für die Plattform stehen, auf der Du gerade baust:
<os>= Betriebssystem, alsolinux,windowsoderdarwin(ja,darwin- nichtmacos)<arch>= Architektur, z.B.amd64
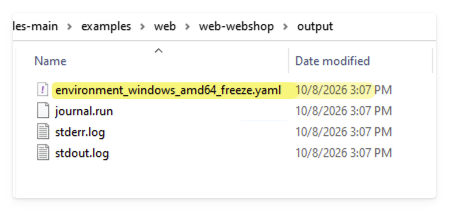
Schiebe diese Datei nun eine Ebene nach oben ins Robot-Verzeichnis (neben conda.yaml).
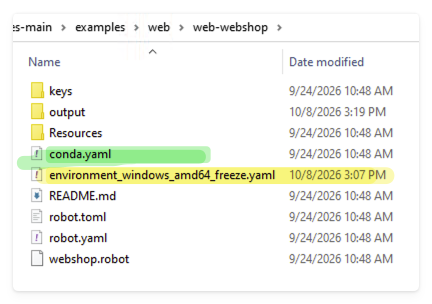
Öffne dann robot.yaml und trage die Freeze-Datei unter dem Key environmentConfigs vor der conda.yaml ein.
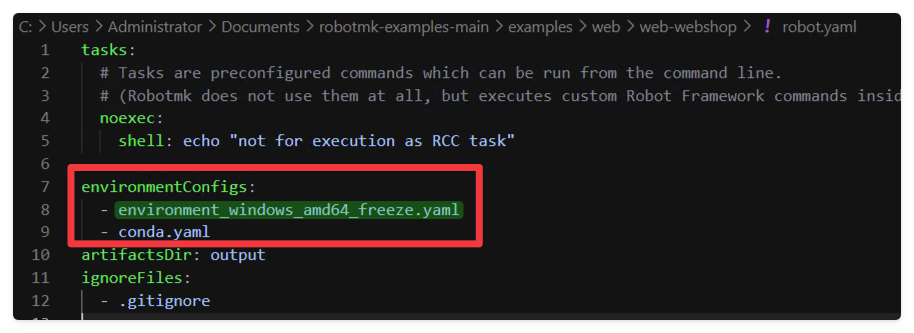
Achte darauf, dass
conda.yamlin der Liste ganz unten steht und die plattformspezifischen Freeze-Files davor. RCC verwendet als Bauplan die Datei, die zuerst auf die Plattform passt;conda.yamlist der Fallback.
Möchtest Du das Environment auch auf Linux nutzen, wiederhole dort einfach den kompletten Schritt 2.
Schritt 3 - Karenzzeit von Python-Paketen prüfen
Wir stellen als Regel auf, keine Python-Abhängigkeiten laden zu wollen, die jünger als 14 Tage sind. Statistisch deckt das schon den Großteil der realen Angriffsfenster ab.
Um das zu prüfen, habe ich depguard.py geschrieben. Du kannst es hier herunterladen.
Leg es ins Robot-Verzeichnis und führe es mit rcc task script direkt im Environment aus:
rcc task script --space refbuild -- python3 depguard.py grace-check
  394 d  ok       cffi 2.0.0
  169 d  ok       click 8.3.3
  192 d  ok       grpcio 1.80.0
  192 d  ok       grpcio-tools 1.80.0
 1206 d  ok       natsort 8.4.0
  984 d  ok       overrides 7.7.0
 1174 d  ok       pip 23.2.1
  407 d  ok       prompt_toolkit 3.0.52
  204 d  ok       protobuf 6.33.6
  253 d  ok       psutil 7.2.2
  260 d  ok       pycparser 3.0
  280 d  ok       PyNaCl 1.6.2
  377 d  ok       PyYAML 6.0.3
  406 d  ok       questionary 2.1.1
  300 d  ok       robotframework 7.4
  239 d  ok       robotframework-assertion-engine 4.0.0
  185 d  ok       robotframework-browser 19.14.2
 2016 d  ok       robotframework-crypto 0.3.0
  265 d  ok       robotframework-pythonlibcore 4.5.0
  491 d  ok       seedir 0.5.1
  255 d  ok       setuptools 80.10.2
  409 d  ok       typing_extensions 4.15.0
  159 d  ok       wcwidth 0.7.0
  259 d  ok       wheel 0.46.3
  216 d  ok       wrapt 2.1.2
Die Ausgabe zeigt: alles ok, alle Pakete sind mindestens 14 Tage alt.
Was macht das Script genau?
- Es legt die Prüfliste an, indem es
pip freeze --allaufruft und inrequirements.txtspeichert. - Es analysiert
requirements.txt, um zurückgezogene Releases zu erkennen (Flag:YANKED). Ein von PyPI zurückgezogenes Release ist ein Warnsignal. - Es liefert einen Exitcode > 0 bei jedem Fund - also ist es skriptbar und auch für einen CI-Lauf brauchbar.
Drei Schalter erlauben das Feintuning:
--min-age DAYSändert die Karenzzeit (Default 14)-f FILEprüft eine andere Datei (das überspringtpip freeze)-ybeantwortet alle Rückfragen mit ja, falls kein Terminal da ist.
Was tun bei Funden?
Wenn das Script bei Dir Pakete meldet, die zurückgezogen wurden oder jünger als 14 Tage sind, öffne conda.yaml und ändere die Version des Pakets auf die letzte Version, die älter als 14 Tage ist. Du kannst das Alter der Versionen jederzeit auf PyPI nachschauen.
Man könnte nun einwenden, dass man durch die Festlegung auf ältere Versionen ja bewusst Verbesserungen außen vor lässt. Schließlich werden neue Lücken ja erst in neueren Versionen geschlossen.
Wenn man aber auf den Zeitstrahl schaut, erkennt man: Die Karenzzeit von lediglich 14 Tagen schützt vor unbekannter, absichtlicher Manipulation. Du nimmst einfach die neueste Version, die älter als 14 Tage ist - und das ist praktisch immer eine gefixte.
Schritt 4 - Auf Schwachstellen prüfen
Jetzt die zweite Frage: Sind in den Paketen bekannte Lücken?
Das beantwortet der OSV-Scanner von Google, der die Datenbank osv.dev abfragt.
Und auch hier übernimmt depguard.py die Arbeit:
rcc task script --space refbuild -- python3 depguard.py osv-scan
Ohne Argument prüft es beide für uns relevanten Bereiche:
- Python (requirements.txt)
- NodeJS (package-lock.json)
Das Script erwartet das
osv-scanner-Binary imPATHoder im aktuellen Verzeichnis - andernfalls fragt es, ob es den Scanner herunterladen soll, und prüft den Download gegen die von Google veröffentlichte Checksumme. (Das ist der “Streber-Modus” - für einen Artikel über Supply Chains wäre alles andere auch schlecht zu rechtfertigen. 😄 )
Erwähnenswert ist, dass das package-lock.json der Browser Library alles enthält, was die Entwickler brauchen - nicht das, was bei Dir installiert wird.
Im untersuchten Stand sind das 807 Einträge, von denen 722 mit "dev": true markiert sind.
Ein naiver Scan prüft also zu 90 % Zeug, das nie auf einem Robotmk-Host landet.
depguard.py filtert die Dev-Einträge deshalb automatisch aus einer Kopie des Lockfiles heraus, bevor es scannt, und sagt Dir, was es getan hat:
=== osv-scan node: package-lock.json ===
dev dependencies excluded: 722 skipped, 84 scanned (use --dev to include them)
(Mit --dev bekommst Du die vollständige Liste, wenn Du sie sehen willst.)
Übrig bleiben vier Pakete; die gefundenen Lücken sind real: protobufjs (12 Advisories), @grpc/grpc-js (4), @protobufjs/utf8 (1) und uuid (1).
Die Ausgabe lesen
So sieht ein Ergebnis aus (hier die Python-Seite, gekürzt):
Total 2 packages affected by 8 known vulnerabilities (0 Critical, 1 High, 6 Medium, 1 Low, 0 Unknown) from 1 ecosystem.
8 vulnerabilities can be fixed.

+-------------------------------------+------+-----------+------------+---------+---------------+
| OSV URL                             | CVSS | ECOSYSTEM | PACKAGE    | VERSION | FIXED VERSION |
+-------------------------------------+------+-----------+------------+---------+---------------+
| https://osv.dev/PYSEC-2026-196      | 8.0  | PyPI      | pip        | 23.2.1  | 26.1.2        |
| https://osv.dev/GHSA-wf93-45jw-7689 |      |           |            |         |               |
| https://osv.dev/PYSEC-2023-228      | 6.8  | PyPI      | pip        | 23.2.1  | 23.3          |
| https://osv.dev/GHSA-mq26-g339-26xf |      |           |            |         |               |
| https://osv.dev/PYSEC-2026-3447     | 6.1  | PyPI      | setuptools | 80.10.2 | 83.0.0        |
| https://osv.dev/GHSA-h35f-9h28-mq5c |      |           |            |         |               |
+-------------------------------------+------+-----------+------------+---------+---------------+
Das sieht jetzt erst einmal gruselig aus. Dinge, die man wissen muss, um das richtig zu lesen:
OSV URL: Dort kann man die Details der Lücke/Schwachstelle nachlesen.- Jeder Fund steht mit zwei IDs da, einer
PYSEC-und einerGHSA-- das sind Aliasse für dasselbe Problem.
- Jeder Fund steht mit zwei IDs da, einer
CVSS-Base-Score: Die Grenzen sind:- 0,1-3,9 = Low
- 4,0-6,9 = Medium
- 7,0-8,9 = High
- 9,0-10,0 = Critical
ECOSYSTEM: PyPI = Python, npm = NodeJSPACKAGE: Name des Pakets, das die Lücke enthältFIXED VERSION: Sagt Dir, in welcher Version die Lücke behoben ist.
Behalte aber auch im Kopf, dass das CVSS ein Maß für Schwere ist, nicht für Risiko. (Der Score weiß nicht, ob Dein Robot die betroffene Funktion überhaupt aufruft.)
Schritt 5 - Bewerten und entscheiden
Null Funde sind nicht das Ziel - sie sind bei einem Environment aus Python, NodeJS und einem Browser auch nicht erreichbar.
Die Funde oben stecken ausschließlich in pip und setuptools: Build-Werkzeug, das im Environment liegt, aber zur Testlaufzeit nicht aufgerufen wird.
Das wird nie null, solange pip mitinstalliert ist.
Der Anspruch heißt deshalb nicht “keine Funde”, sondern “keine unbewerteten Funde”. Arbeite die Liste in dieser Reihenfolge durch - CVSS kommt darin zuletzt:
- Ist das Paket überhaupt installiert? Auf der npm-Seite fällt damit der größte Teil weg.
- Läuft es zur Testlaufzeit oder nur beim Bauen? Damit sind
pipundsetuptoolserledigt. - Nutzt der Robot diesen Codepfad?
- Erst jetzt CVSS - als Reihenfolge innerhalb des Rests, nicht als Einstieg.
Versionen hochziehen (Python)
Entscheidest Du Dich, die Version eines Paketes zu ändern, zeigt Dir die Spalte FIXED VERSION die Zielversion.
Das betroffene Paket steht mit hoher Wahrscheinlichkeit gar nicht in der conda.yaml, sondern ist eine der vielen transitiven Abhängigkeiten.
Deshalb trägst Du die Zielversion ins Freeze-File ein.
Beispiel:
- pip:
  - requests==2.31.0      # direkte Abhängigkeit
  - urllib3==1.26.18      # transitiv, in conda.yaml nicht erwähnt
Welche Sektion die richtige ist, sagt Dir das Freeze-File selbst:
- Steht das Paket über dem
- pip:-Schlüssel, kommt es von conda-forge: Achtung, hier nur ein Gleichheitszeichen, z.B.openssl=3.6.5. - Steht es darunter, ist es ein pip-Paket: zwei Gleichheitszeichen, z.B.
cffi==2.1.0.
Tipp: Schreib die geänderte Version zusätzlich in die
conda.yaml, zusammen mit einem Kommentar. Nicht weil sie dort effektiv wirkt, sondern weil diese Info sonst verloren geht, sobald jemand das Freeze-File löscht und neu baut.
Nochmal: Dieconda.yamlist Dein Absichtsdokument - ein Kommentar wie# CVE-Fix, siehe GHSA-...manifestiert die Entscheidung, die Du getroffen hast.
Zwei Dinge danach:
- Lass
depguard.py grace-checknach dem Rebuild erneut laufen, um sicherzustellen, dass die Karenzzeit eingehalten wird. - Kann pip die Fixversion nicht auflösen, weil eine direkte Abhängigkeit sie ausschließt, so musst Du die direkte Abhängigkeit hochziehen, nicht die transitive.
Versionen hochziehen (NodeJS)
Ein Wermutstropfen: Bei den NodeJS-Packages kannst Du nicht bestimmen, welche Version installiert wird.
Das steht in der package-lock.json, die die Entwickler mit der Browser Library mitgeliefert haben.
Wenn der OSV-Scanner also Pakete darin bemängelt, bleiben Dir drei Möglichkeiten:
robotframework-browserauf eine Version hochziehen, deren mitgeliefertes Lockfile den Fix enthält- bewerten und akzeptieren - es ist die gRPC-Brücke zwischen Python und NodeJS, kein von außen erreichbarer Angriffspfad
- die Lücke den Maintainern der Browser Library melden (=Pull Request auf GitHub)
Schritt 6 - Exportieren
Schritt 5 musst Du gegebenenfalls in mehreren Iterationen durchlaufen.
Nun exportierst Du das Environment in eine ZIP-Datei.
Diesen Vorgang habe ich hier bereits ausführlich beschrieben: Robotmk and RCC-Environments in air-gapped environments.
Deshalb hier nur die Kurzform:
cd web-webshop
set ROBOCORP_HOME=C:\robotmk\rcc_home\current_user
rcc holotree vars --space refbuild --robot robot.yaml
rcc holotree export --robot robot.yaml --zipfile win_rf-web.zip
Selbstverständlich wird die dabei entstandene ZIP-Datei nicht in ein Git-Repo eingecheckt.
Sie ist ein Binärartefakt, das sich nicht sinnvoll versionieren lässt.
Du kannst sie entweder manuell auf die Zielsysteme kopieren, Ansible dafür nutzen, oder auf einem NFS-Share ablegen, auf das die Zielsysteme Zugriff haben.
Sicherheit ist ein Prozess, kein Zustand
Natürlich ist es mit diesem einmaligen Scan nicht getan.
Wie Du den Prozess bei Dir integrierst, hängt von Deiner Umgebung ab.
Zur Inspiration hier ein einfacher Cronjob, der einmal pro Woche die Python- und NodeJS-Pakete scannt und die Ergebnisse per Mail verschickt:
0 6 * * 1  osv-scanner scan source --no-resolve --config=/srv/robots/foo/osv-scanner.toml \
             -L requirements.txt:/srv/robots/foo/requirements.txt \
             -L package-lock.json:/srv/robots/foo/package-lock.json
Du könntest daraus z.B. ein Script bauen, das dann per Local Check das Ergebnis in Checkmk meldet.
In einer osv-scanner.toml kannst Du z.B. auch hinterlegen, welche Pakete Du bewusst akzeptierst, und wann die Bewertung verfällt:
[[IgnoredVulns]]
id = "GHSA-2pr8-phx7-x9h3"
ignoreUntil = 2026-11-30
reason = "protobufjs: betroffener Codepfad wird vom Robot nicht erreicht. Bewertet 2026-08-31."
Wenn Du weiter aus dem Internet bauen willst
Nicht jede Umgebung braucht gleich das ZIP-Artefakt-Modell, und der Standardbetrieb bleibt vollkommen legitim: die Hosts bauen selbst, ziehen ihre Pakete aus dem Internet.
Wenn Du aus diesem Artikel nur eine Sache mitnimmst, dann diese: Mach die Schritte 2 bis 5 trotzdem.
Das Freeze-File ist der Teil des Konzepts, der auch beim Bezug übers Internet funktioniert - und der ist wirklich geschenkt.
Allein damit ist die Gefahr schon viel geringer, dass Dir in den Sub-Dependencies ein anders, schädliches Paket untergeschoben wird.
Das ZIP-File bringt darüber hinaus den Komfort, stets genau das Environment zu bekommen, das Du schon einmal selbst gebaut und geprüft hast.
Abseits davon kannst Du mit zwei speziellen Umgebungsvariablen dafür sorgen, dass die Browser-Binaries an einem gemeinsamen Ort (außerhalb der Environments) bereitliegen, bzw. von einem internen statt von einem CDN-Server geladen werden:
# Browser-Binaries einmal bereitstellen, Hosts laden nichts nach
PLAYWRIGHT_BROWSERS_PATH=/opt/pw-browsers

# oder: den Download-Weg umlenken statt den CDN direkt zu nutzen
PLAYWRIGHT_DOWNLOAD_HOST=https://<eigener-host>
Was das Konzept nicht leistet
👆 Damit hier keiner mit falschen Erwartungen rausgeht:
- Die Karenzzeit verkleinert das Fenster, sie schließt es nicht.
- Ungeprüft bleibt, ob das ZIP auf dem Host auch wirklich das ist, das Du erzeugt hast.
- Ein grüner Scan ist ein Zustand, keine Eigenschaft; er gilt ausschließlich für den Prüfzeitpunkt.
- Das Freeze-File pinnt Name und Version - keinen Hash und keinen Index.
Ein kompromittierter Spiegelserver, ein unsicher konfigurierter Proxy etc. können Dir immer noch ein manipuliertes Paket unterjubeln.
Fazit
Uff, der Artikel ist länger geworden als geplant. 😄
Angefangen hat das alles mit der Frage eines Kunden zur korrekten Anwendung von RCC.
Herausgekommen ist (hoffentlich) kein Artikel, der Angst macht, sondern Awareness dafür schafft, wo die Lieferkette eines RCC-Environments belastbar ist und wo nicht.
Jetzt interessiert mich Deine Sicht: Baut Ihr Eure Environments auf jedem Host - oder habt Ihr das längst zentralisiert? Und falls ja: Woran ist es bei Euch gescheitert, bevor es funktioniert hat? Schreib es in die Kommentare oder schick mir eine Mail.